Estadística exploratoria
Ejercicio exploratory-statistics-annex.pdf · PDF
Sin ejecutar nada: ¿cuánto cuesta un juego típico de Steam? Di un número. Apúntalo, incluso.
Llevas semanas limpiando games_clean. Te sabes sus columnas de memoria. Y aun así tienes que adivinar, porque nadie le ha hecho todavía a la tabla ni una sola pregunta. Hoy se la haces. La respuesta serán dos números que no se ponen de acuerdo, y entender por qué discrepan es la pieza de estadística más útil que aprenderás nunca.
Qué aprenderás
- Calcular la media y la mediana de una columna en SQL, y decir cuál de las dos mueve un solo valor extremo
- Describir la dispersión de una columna: mínimo, máximo, cuartiles y desviación estándar
- Construir una tabla de frecuencias con
width_buckety leer en ella la forma de una distribución - Distinguir una columna sesgada de una simétrica solo comparando media y mediana
- Elegir el número que responde con honestidad a "¿qué es lo típico?"
- La trampa: por qué "el juego medio cuesta 7.91" describe un juego que casi no existe
Hoy produces los números; la próxima lección los convierte en el informe.
La cola: dos clases de centro
La estadística exploratoria consiste en describir una columna con un puñado de números antes de dibujar o concluir nada: dónde está su centro, cuánto se dispersa y qué forma tiene.
Cinco amigos comparan lo que ganan en un mes. Cuatro tienen trabajos normales. El quinto es un streamer que ha tenido un mes muy bueno.
1 200 1 300 1 400 1 500 30 000
¿Qué gana un amigo típico? Hay dos maneras honestas de responder.
La media (el "promedio" de todos los días) es lo que recibiría cada uno si se sumara todo y se repartiera a partes iguales.
Suma los cinco: 35,400. Reparte entre cinco: 7,080.
La mediana es el valor del que queda en el medio cuando todos hacen cola de menor a mayor.
Ponlos en cola por ingresos. El tercero de cinco está en el medio: 1,400.
| Cómo | Aquí | Qué le hace el streamer | |
|---|---|---|---|
| Media | Sumar todo y repartir a partes iguales | 7,080 | La arrastra hacia arriba. Nadie del grupo gana algo parecido a 7,080 |
| Mediana | Hacer cola por tamaño y coger al que está en el medio | 1,400 | Nada. El streamer es simplemente "el último de la cola", gane lo que gane |
Dale al streamer 300,000 en lugar de 30,000. La media salta a 61,080. La mediana sigue en 1,400.
Nos quedamos con la cola durante toda la página. Pon los datos en cola, el menor primero. La mitad están delante de la mediana, la mitad detrás. Todo lo que calcules hoy es una pregunta sobre esa cola:
| Pregunta | En la cola | SQL |
|---|---|---|
| Centro | ¿Dónde está el medio? | AVG, PERCENTILE_CONT(0.5) |
| Dispersión | ¿A qué distancia están el primero y el último? ¿Y la mitad central? | MIN, MAX, STDDEV, percentiles 0.25 y 0.75 |
| Forma | ¿Dónde se amontona la cola? | width_bucket + COUNT(*) |
Centro: lo mismo con 26,685 juegos
Ahora, la cola de verdad. Antes de ejecutarla, apuesta: ¿la media del precio será mayor o menor que la mediana?
SELECT ROUND(AVG(price), 2)                               AS mean,
       PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY price) AS median
FROM games_clean;
| mean | median |
|---|---|
| 7.91 | 4.99 |
La media es AVG, una vieja amiga de SQL Lab: grupos. La mediana necesita una línea más larga. Léela pieza a pieza:
| Pieza | En la cola |
|---|---|
WITHIN GROUP (ORDER BY price) |
"Haz la cola por precio" |
PERCENTILE_CONT(0.5) |
"Camina hasta el 50% de la cola y lee el valor que hay ahí" |
Un percentil es una posición en la cola, dada como una fracción: 0.5 es el medio, 0.25 es un cuarto del camino.
PostgreSQL no tiene una función MEDIAN(). La mediana es el percentil 0.5.
Entonces, ¿cuál es: un juego cuesta 7.91 dólares o 4.99? Los dos números son correctos. Responden a preguntas distintas. Para ver a cuál, necesitas el resto de la cola.
Dispersión: a qué distancia
Un centro solo esconde demasiado. "El juego del medio cuesta 4.99" es verdad tanto si todos los juegos cuestan 4.99 como si los precios van de cero a cientos. Empieza por los dos extremos de la cola:
SELECT COUNT(*) AS n, MIN(price) AS lowest, MAX(price) AS highest,
       ROUND(AVG(price), 2) AS mean,
       PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY price) AS median
FROM games_clean;
| n | lowest | highest | mean | median |
|---|---|---|---|---|
| 26,685 | 0.00 | 595.99 | 7.91 | 4.99 |
¿Un juego a 595.99? Nunca des un máximo sin mirar quién es:
SELECT game, price FROM games_clean ORDER BY price DESC LIMIT 3;
| game | price |
|---|---|
| ADR-Labelling Game | 595.99 |
| GameMaker Studio 2 UWP | 399.99 |
| VEGAS Pro 16 Edit Steam Edition | 399.00 |
El segundo es una herramienta para hacer juegos y el tercero es un editor de vídeo. Son software vendido en Steam, no juegos. Son los streamers de nuestra cola.
Los extremos de la cola los fija una sola fila cada uno. Una forma más robusta de describir la dispersión es cortar la cola en cuatro partes iguales.
Los cuartiles son los tres cortes que dividen la cola en cuatro partes con el mismo número de filas: Q1 al 25%, la mediana al 50%, Q3 al 75%.
La desviación estándar es, a grandes rasgos, la distancia típica entre un valor y la media. (La fórmula exacta eleva las distancias al cuadrado primero; hoy no la necesitas, y
STDDEVlo hace por ti.)
SELECT ROUND(STDDEV(price), 2) AS std_dev,
       PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY price) AS q1,
       PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY price) AS q3
FROM games_clean;
| std_dev | q1 | q3 |
|---|---|---|
| 11.79 | 1.99 | 9.99 |
Entre Q1 y Q3 está la mitad central de la cola. Así que puedes escribir una frase corta, exacta y verdadera: la mitad de los juegos cuesta entre 1.99 y 9.99 dólares.
Cuidado: la desviación estándar no es un rango de precios
Es tentador leer "media 7.91, desviación estándar 11.79" como "los precios van de 7.91 − 11.79 a 7.91 + 11.79". El extremo inferior saldría negativo, y ningún juego cuesta menos que nada. En una columna como esta, la desviación estándar se infla por los pocos valores enormes del final de la cola. Los cuartiles describen mejor la dispersión.
Forma: dónde se amontona la cola
Centro y dispersión siguen siendo solo números. Para ver la cola necesitas su forma.
Una distribución es cómo se reparten los valores de una columna: cuáles son comunes y cuáles raros.
La forma más sencilla de verla es una tabla de frecuencias: corta el rango en cajas del mismo ancho y cuenta cuántas filas caen en cada caja.
width_bucket(value, from, to, n) te dice en cuál de n cajas iguales entre from y to cae un valor. Abajo: seis cajas de 10 dólares de 0 a 60. Todo lo que pasa de 60 va a una caja extra, la número 7. La última columna dibuja una barra: un # por cada 500 juegos.
SELECT width_bucket(price, 0, 60, 6) AS bucket,
       MIN(price) AS lowest, MAX(price) AS highest, COUNT(*) AS games,
       REPEAT('#', (COUNT(*) / 500)::int) AS bar
FROM games_clean GROUP BY bucket ORDER BY bucket;
 bucket | lowest | highest | games | bar
--------+--------+---------+-------+--------------------------------------------
      1 |   0.00 |    9.99 | 21318 | ##########################################
      2 |  10.00 |   19.99 |  4101 | ########
      3 |  20.00 |   29.99 |   701 | #
      4 |  30.00 |   39.99 |   269 |
      5 |  40.00 |   49.99 |   117 |
      6 |  54.99 |   59.99 |    96 |
      7 |  64.99 |  595.99 |    83 |
Ahí está la cola. Casi todo el mundo está apiñado en la primera caja: 21,318 juegos de 26,685 cuestan menos de 10 dólares. Después, una larga y fina hilera de rezagados se estira hacia la derecha, hasta 595.99.
¿Por qué la caja 6 empieza en 54.99 y no en 50?
Las columnas lowest y highest muestran el juego más barato y el más caro encontrados en cada caja, no los bordes de la caja. La caja 6 cubre de 50 a 60, pero ningún juego de esta tabla cuesta entre 50.00 y 54.98.
Haz lo mismo con una segunda columna, metascore, la puntuación de las reseñas de 0 a 100. Dos cambios: solo los juegos que tienen puntuación (WHERE has_metascore), y una conversión a numeric, porque ROUND con decimales no acepta directamente el tipo de esa columna.
SELECT COUNT(*) AS n, MIN(metascore) AS lowest, MAX(metascore) AS highest,
       ROUND(AVG(metascore)::numeric, 1) AS mean,
       PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY metascore) AS median,
       ROUND(STDDEV(metascore)::numeric, 1) AS std_dev,
       PERCENTILE_CONT(0.25) WITHIN GROUP (ORDER BY metascore) AS q1,
       PERCENTILE_CONT(0.75) WITHIN GROUP (ORDER BY metascore) AS q3
FROM games_clean WHERE has_metascore;
| n | lowest | highest | mean | median | std_dev | q1 | q3 |
|---|---|---|---|---|---|---|---|
| 2,849 | 20 | 98 | 71.9 | 73 | 11.0 | 66 | 80 |
SELECT width_bucket(metascore, 20, 100, 8) AS bucket,
       MIN(metascore) AS lowest, MAX(metascore) AS highest, COUNT(*) AS games,
       REPEAT('#', (COUNT(*) / 25)::int) AS bar
FROM games_clean WHERE has_metascore GROUP BY bucket ORDER BY bucket;
 bucket | lowest | highest | games | bar
--------+--------+---------+-------+--------------------------------------------
      1 |     20 |      29 |     8 |
      2 |     30 |      39 |    21 |
      3 |     40 |      49 |    85 | ###
      4 |     50 |      59 |   261 | ##########
      5 |     60 |      69 |   666 | ##########################
      6 |     70 |      79 |  1055 | ##########################################
      7 |     80 |      89 |   677 | ###########################
      8 |     90 |      98 |    76 | ###
Una cola completamente distinta. Esta es una colina: pocos juegos abajo, pocos arriba y una multitud en el medio, entre 70 y 79.
Dos formas: la cola larga y la colina
Aquí tienes las dos tablas de frecuencias como imagen, con la media y la mediana marcadas.
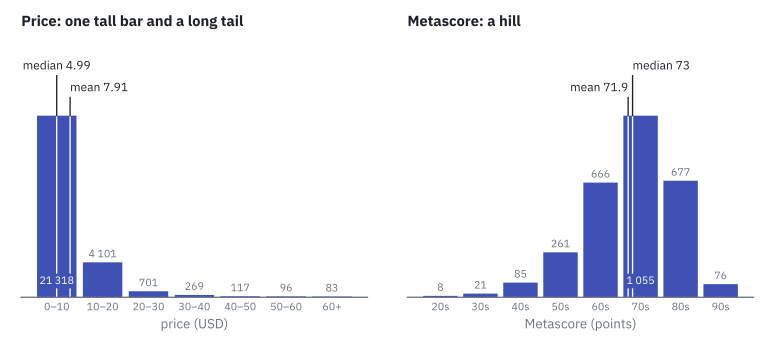
Una distribución es sesgada cuando la mayoría de los valores se amontonan en un lado y una larga cola de valores raros se estira por el otro. Es simétrica cuando los dos lados del centro se parecen más o menos.
price |
metascore |
|
|---|---|---|
| Forma | Una barra alta y una cola larga a la derecha: sesgada | Una colina: más o menos simétrica |
| Media | 7.91 | 71.9 |
| Mediana | 4.99 | 73 |
| Media frente a mediana | Muy separadas: la media es un 58% más alta | Muy cerca: un punto de diferencia aproximadamente |
| Quién tira de la media | 83 productos de 60 dólares o más, hasta 595.99 | Nadie en particular |
Ahora puedes saber la forma sin dibujar nada. Compara los dos centros. Si están lejos, hay una cola y la media se ha arrastrado hacia ella. Si están cerca, hay una colina.
Cuidado: el promedio no siempre es el valor típico
"La mayoría de los juegos cuesta unos 7.91" suena razonable y es falso. Solo 10,218 de los 26,685 juegos cuestan más que la media; el 62% cuesta menos. Es el efecto streamer: unos pocos productos muy caros alejan la media de donde está realmente la cola.
Cuando media y mediana discrepan, la mediana describe el caso típico y la media describe el total (multiplícala por el número de juegos y obtienes la suma de todos los precios). Ninguna está equivocada. Responden a preguntas distintas.
¿Qué número imprimimos?
Vuelve al número que apuntaste al principio. ¿Te acercaste? ¿A cuál de los dos?
En la próxima lección escribes un informe, y una línea dirá cuánto cuesta un juego. Si imprimes 7.91, describes un juego que casi no existe. Aquí tienes el mismo hecho, escrito de tres maneras:
| Frase | Veredicto |
|---|---|
| "El precio medio es 7.91." | Cierta, y engañosa: sin unidad, y sin avisar de que la mayoría de los juegos cuesta menos |
| "Los juegos cuestan unos 5 dólares." | Más cerca, pero vaga: ¿qué número es ese y cuánta seguridad tienes? |
| "El juego típico cuesta 4.99 USD (mediana). La mitad de los juegos cuesta entre 1.99 y 9.99 USD. La media es más alta, 7.91 USD, porque unos pocos productos cuestan hasta 595.99 USD." | El centro, la dispersión y la forma, en tres frases cortas |
Un número sin su forma es media verdad. Imprime la mediana, los cuartiles, y di con palabras que hay una cola.
Pruébalo
Usa games_clean en SQL Lab (base de datos Dades classe, esquema public). Construye tu propia ficha estadística: una tabla pequeña con ocho números por columna.
| n | lowest | highest | mean | median | std_dev | Q1 | Q3 | |
|---|---|---|---|---|---|---|---|---|
price |
||||||||
metascore |
Paso 1 — Ejecuta las consultas de esta página y rellena las dos filas. Tus números tienen que coincidir con los de arriba.
Paso 2 — Cuenta cuántos juegos cuestan más que la media, con WHERE price > 7.91. Deberías obtener 10,218.
Paso 3 — En papel, dibuja un esbozo de las siete barras de price y las ocho de metascore. Marca dónde caen la media y la mediana en cada esbozo.
Paso 4 — ¿Los juegos Hit cuestan más? Añade un grupo a la primera consulta:
SELECT owners_tier, ROUND(AVG(price), 2) AS mean,
       PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY price) AS median
FROM games_clean GROUP BY owners_tier;
| owners_tier | mean | median |
|---|---|---|
| Hit | 13.99 | 9.99 |
| Mid | 8.60 | 4.99 |
| Niche | 7.38 | 4.99 |
Paso 5 — Termina las dos frases: "Un juego típico cuesta __ porque..." y "Un juego con reseñas típico puntúa __ porque...". Guarda la ficha: es la materia prima de tu informe.
Si SQL Lab protesta
function round(double precision, integer) does not exist significa que estás redondeando la columna metascore tal como está. Conviértela antes: ROUND(AVG(metascore)::numeric, 1). Y si aparece una fila con bucket vacío, falta el WHERE has_metascore: los juegos sin puntuación no caen en ninguna caja.
Ideas clave
- La estadística exploratoria describe una columna con unos pocos números: centro, dispersión y forma.
- La media suma todo y lo reparte a partes iguales; la mediana es el medio de la cola. Un valor extremo mueve la media y deja la mediana donde estaba.
- PostgreSQL no tiene
MEDIAN(): usaPERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY column). Los cuartiles Q1 y Q3 son los percentiles 0.25 y 0.75. - Una tabla de frecuencias con
width_bucketyCOUNT(*)muestra la distribución: dónde se amontonan los valores. priceestá sesgada (media 7.91, mediana 4.99, una cola hasta 595.99).metascorees más o menos simétrica (media 71.9, mediana 73).- Media y mediana muy separadas significan que hay una cola. En una columna sesgada, da la mediana y los cuartiles, y di que hay una cola.
Comprobación rápida
1. Cinco amigos ganan 1,200, 1,300, 1,400, 1,500 y 30,000. Los ingresos del último suben a 300,000. ¿Qué pasa?
- Suben tanto la media como la mediana
- La media sube mucho; la mediana se queda en 1,400
- La mediana sube mucho; la media se queda en 7,080
- No cambia ninguna, porque es solo una persona
La media lo suma todo, así que un valor enorme la arrastra: de 7,080 a 61,080. La mediana solo se fija en quién está en el medio de la cola. El streamer sigue siendo "el último", gane lo que gane.
2. ¿Qué SQL da la mediana del precio en PostgreSQL?
-
AVG(price) -
(MIN(price) + MAX(price)) / 2 -
PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY price) -
STDDEV(price)
La mediana es el percentil 0.5: haz la cola por precio, camina hasta el 50% y lee el valor. A medio camino entre el más bajo y el más alto estaría cerca de 298, un precio que casi ningún juego tiene. La mediana real es 4.99.
3. La media del precio es 7.91 y la mediana es 4.99. ¿Qué te dice esa diferencia?
- Que una de las dos consultas tiene un error
- Que la mitad de los juegos cuesta exactamente 7.91
- Que la distribución es sesgada: una cola de productos caros tira de la media hacia arriba
- Que los precios se reparten de forma uniforme entre 4.99 y 7.91
Cuando media y mediana están muy separadas, hay una cola. Aquí 83 productos cuestan 60 dólares o más, hasta 595.99, y arrastran la media. En metascore, una colina, los dos centros están a un punto de distancia aproximadamente.
4. Q1 de price es 1.99 y Q3 es 9.99. ¿Qué frase es correcta?
- La mitad de los juegos cuesta entre 1.99 y 9.99
- Una cuarta parte de los juegos cuesta entre 1.99 y 9.99
- Ningún juego cuesta menos de 1.99 ni más de 9.99
- La media tiene que estar exactamente a medio camino, en 5.99
Los cuartiles cortan la cola en cuatro partes iguales. Entre Q1 (25%) y Q3 (75%) está la mitad central de las filas. Una cuarta parte de los juegos es más barata que Q1 y otra cuarta parte es más cara que Q3.
5. Un compañero escribe: la mayoría de los juegos cuesta unos 7.91, la media. ¿Qué tiene de malo esta frase?
- Nada: el promedio es siempre el valor típico
- La media en realidad es 4.99
- Solo 10,218 de 26,685 juegos cuestan más de 7.91; el 62% cuesta menos
- No se puede calcular un promedio con precios
La aritmética es correcta, la lectura no. En una columna sesgada la media queda por encima de la mayoría de las filas. La mediana, 4.99, describe el juego típico; la media describe el total.
6. ¿Qué hace width_bucket(price, 0, 60, 6)?
- Redondea cada precio al múltiplo de 6 dólares más cercano
- Se queda solo con los seis juegos más baratos
- Dice en cuál de seis cajas iguales entre 0 y 60 cae cada precio
- Divide la tabla en seis tablas
Seis cajas de 10 dólares cada una. Junto con GROUP BY y COUNT(*) construye una tabla de frecuencias, que muestra la forma de la distribución. Los precios de 60 o más caen en una caja extra, la número 7.
7. Un pueblo tiene 99 pisos alquilados entre 700 y 900 euros al mes (unos 800 de media) y una mansión a 40,000. El periódico imprime: alquiler medio, unos 1,190 euros. Elige las dos afirmaciones verdaderas.
- La cifra es aritméticamente correcta, pero 99 de cada 100 inquilinos pagan menos que ella
- La mediana, unos 800 euros, describe mejor el alquiler típico
- La cifra es falsa: el periódico cometió un error de cálculo
- La mansión debería contarse dos veces para que el promedio sea justo
Es el streamer otra vez. (99 × 800 + 40,000) ÷ 100 ≈ 1,190, así que la media es correcta y no describe a nadie. Imprime la mediana, PERCENTILE_CONT(0.5) WITHIN GROUP (ORDER BY rent), y menciona el rango de la mitad central.
Ya tienes una ficha llena de números honestos. Pero los números solos no son un informe. Siguiente: El informe descriptivo, donde conviertes la ficha estadística en una página en la que otra persona pueda confiar.